北京发布太空算力云,把推理放到近地轨道
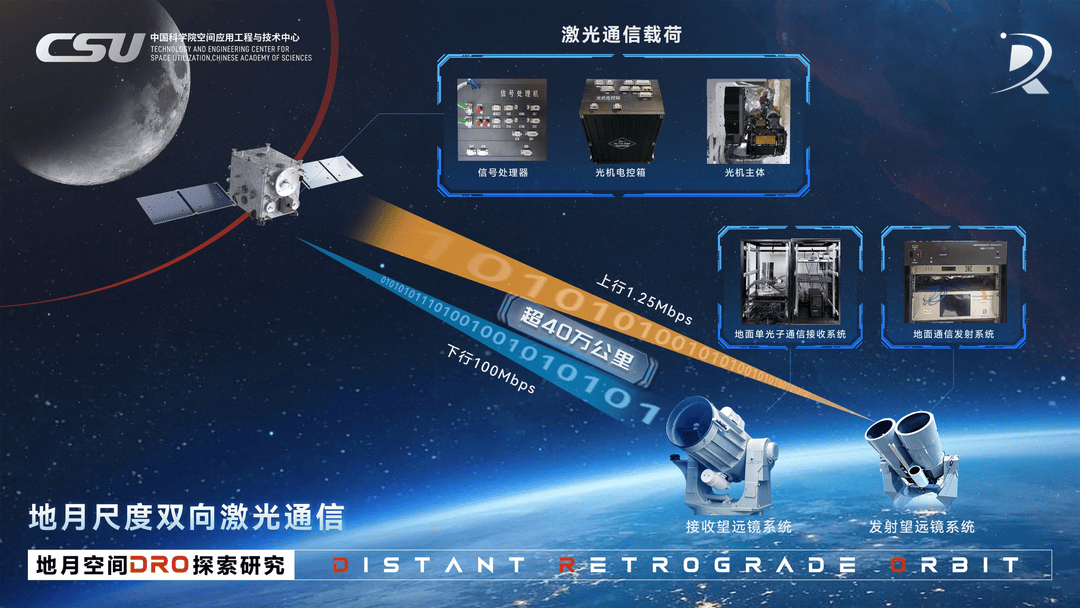
北京发布了太空算力云平台,把 40 多颗卫星上的 CPU、GPU、NPU 统一池化调度,用激光通信连接,配抗辐照 AI 芯片支撑天地一体推理。
这个项目的目标不是替代地面数据中心,而是把边缘推理延伸到近地轨道,解决地面网络覆盖不到的场景。
所以太空算力的现实定位是补充地面网络覆盖不到的角落,而不是与数据中心竞争通用算力。
动机来自遥感数据的处理方式。
卫星拍下的图像如果全部回传地面,带宽成本高、延迟大,很多数据在排队中被浪费。
如果在星上先做初筛与识别,只回传有价值的片段,带宽能省一个数量级。
这对灾害监测、船舶识别、火点预警这类时效敏感的应用很关键。
散热是硬约束,真空环境只能靠辐射散热,单位面积的排热能力有限,算力密度被限制在每瓦对应固定面积。
工程约束比地面严苛得多。
太空没有对流散热,热量只能靠辐射排出去,功率密度被死死限制;太阳能供电有限,算力越强越耗电;宇宙射线会导致单粒子翻转,芯片要做抗辐照加固或冗余设计;激光通信受云层与对准精度影响,链路稳定性远不如光纤。
抗辐照芯片的算力通常落后地面两三代,这意味着星上只能跑轻量模型,复杂推理仍要回传地面完成。
星座规模越大,单星算力的边际价值越高,这也是这门生意能不能成立的前提条件之一。
池化调度是这套系统的核心创新点。
单颗卫星的算力有限,任务又不均匀,把多颗卫星的算力统一编排,可以让任务落到当时最合适的节点上。
这需要解决星间链路的时延、任务的切分与结果的合并,难度类似地面的跨区域调度,但约束更多、容错空间更小。
商业模式上,这类平台更适合卖给遥感与航运客户,它们对时效敏感、对成本不敏感,愿意为分钟级响应付费。
商业闭环仍需验证。
发射成本、卫星寿命、芯片的更替周期,都是账本上的硬约束。
一颗卫星设计寿命五年,而 AI 芯片两年就换代,在轨升级只能靠软件,硬件跟不上。
这意味着太空算力的能力会被锁定在发射那一刻,无法享受地面的迭代速度。
从网络架构看,星间激光链路把单颗卫星的算力连成一张网,任务可以在星座内部迁移,这比把数据全部回传更省带宽。
它更适合被理解为一种补充而非替代。
地面数据中心负责训练与重负载推理,星上负责初筛与实时响应,两者分工。
当低轨星座的规模继续扩大,星上算力会像今天的边缘节点一样成为基础设施的一部分。
真正的门槛不在把芯片送上天,而在让它在天上稳定运行五年。
对国内的星座运营商来说,星上算力还有一个隐性价值:数据在轨处理之后,回传的只是结果,敏感信息不必离开本地。
6万人军演逼近家门口,真正威胁不在海面,500公里近地轨道是关键>>点击查看更多
星舰乘员舱首次曝光:登月真正的难关,还在太空加油>>点击查看更多
极地 “生命线”贯通 国产卫星互联网驶入规模化组网关键期>>点击查看更多
3000颗在轨卫星目标背后:上海卫星互联网的产业链协同与商用节奏>>点击查看更多
热门推荐