Nature警示:量子霸权多半是「造」出来的,不等于量子效用
近几年,“量子优越性”或“量子霸权”可以说是量子圈的热点词汇,全球各大实验室及科技公司围绕其发表了不少亮眼成果。
然而,当我们深入研究会发现,我们现在是造出了能在几百秒内完成经典超算数万年计算任务的机器,但这些计算结果本身,似乎并没有什么实际用处。
最近,《Nature Electronics》发表了一篇题为“Moving quantum computing from engineered advantage to practical utility”的评论文章,文章指出,目前的量子优势很大程度是被“人为工程化”出来的,现在需要解决的核心问题是,如何把这些精心构造的实验转化为具有实际价值的计算能力,以实现其实际效用。
当然,这并不是对过去几年实现的量子优势实验的否定,更多的是随时间变化而带来的评价标准的变化。
现在我们达成共识的,非常明确的一点是:如果在“造”出来的问题上都达不到量子计算优越性(量子霸权),那针对有实际价值问题的量子效用就更加无从谈起了。
量子优越性的底层逻辑
迄今为止,几乎所有关于量子优越性的实验,都是被精心设计出来的。
目前,随机线路采样和玻色采样是实现量子计算优越性的两大主流路径。
两种方法在物理实现上大相径庭,但困难性都是可以设计的。
随即线路采样的难度是高度纠缠的伪混沌态,玻色采样的难度是矩阵积和式的计算复杂度。
简单来说就是挑量子系统擅长但经典计算不擅长的特定任务。
Google在2019年引起轰动的53比特Sycamore实验是个典型样本。
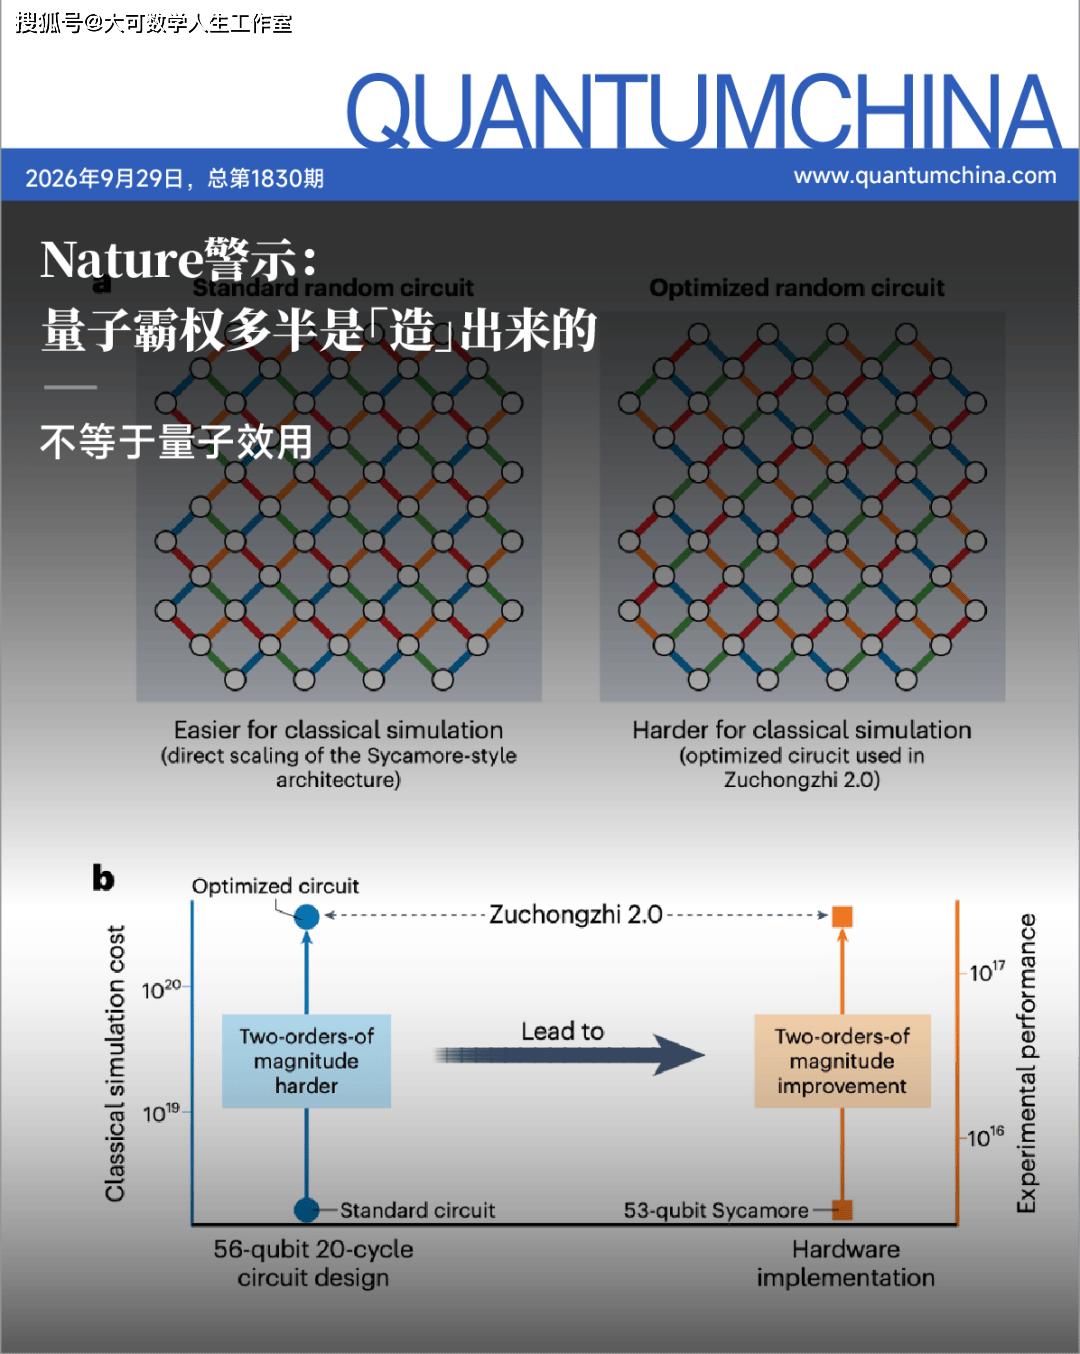
研究团队刻意在硬件层面摒弃了传统的CZ门,转而采用参数化的fSim门,在放宽物理约束的同时制造更复杂的纠缠。
同时,底层拓扑结构被修改为旋转的方形晶格分布,使得经典张量网络在进行缩并时的复杂度呈指数级上升。
到了2021年,56比特的“祖冲之二号” 把这件事做得更明白。
相较于Sycamore,祖冲之二号在量子比特数量上仅有适度的增加,甚至在某些读出保真度指标上不占绝对优势,但它取得了比Sycamore强几个数量级的量子优势。
原因在于其采用了经过严密优化的复杂性设计线路。
事实证明,通过改变双量子比特的连通性和纠缠结构,即便在相同时钟周期和门数量下,也能让经典模拟器彻底宕机。
这种“优势”,很大程度上取决于研究人员如何将计算硬度“嵌入”到硬件系统中。
另一条主要路线是玻色采样。
玻色采样利用多个不可区分光子在复杂干涉网络中的演化进行采样。
早期方案依赖确定性单光子源,实验扩展难度较高;高斯玻色子采样则使用压缩态光源,在保留计算困难性的同时降低了部分实验约束。
中国科学技术大学“九章”、加拿大Xanadu的Borealis等光量子实验,均沿着这一方向扩大光学模式、探测事件和输出样本规模。
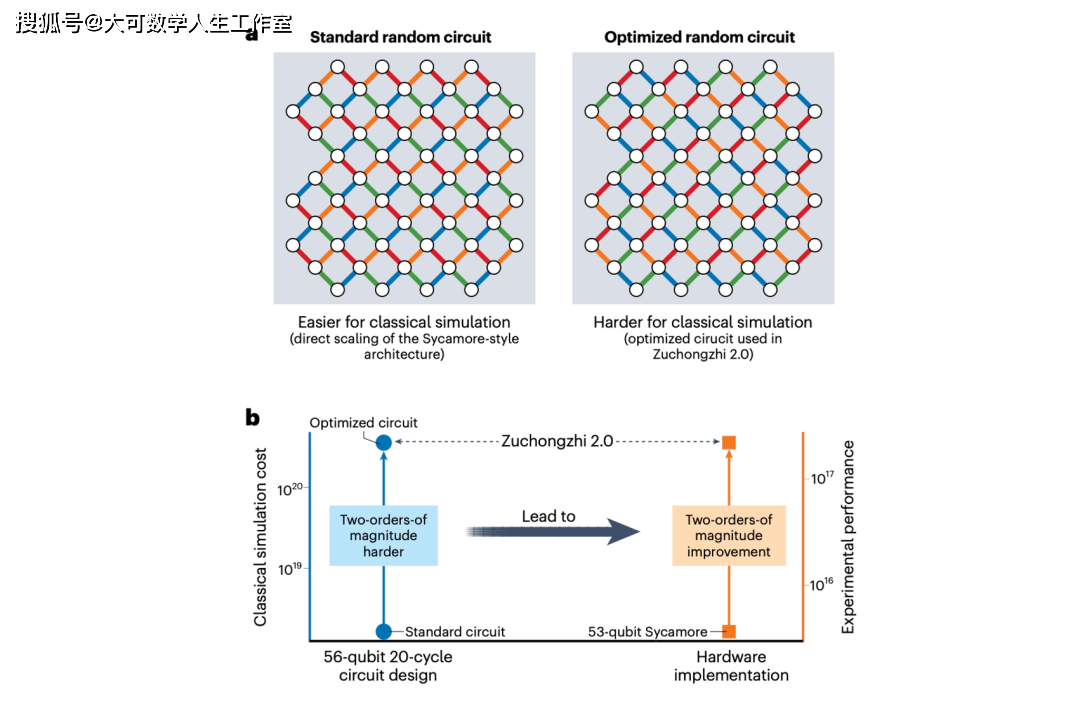
图:面向量子优势的线路设计
这就是所谓的“工程化量子优势”。
这些实验设计的目标之一就是最大化量子和经典能力之间的差距。
这表明,展示优势和确立实际效用是两码事。
动态演进的算力边界
如果认为量子优越性是一个静态里程碑,那就大错特错了。
当前的算力边界一直处于一个不断变化的协同演化阶段。
协同演化是指,量子优势和经典能力之间的边界不是固定的,它反映的是量子设备、问题设计、经典算法三者之间不断变化的平衡。
张量网络方法、混合计算策略、专用硬件加速,这些经典侧的进步一再把边界往前推,缩小了此前被认为经典计算无法触及的区间。
这在Sycamore实验之后表现的淋漓尽致。
谷歌最初给出的经典计算时间估计约为一万年。
随后,借助张量网络(Tensor Networks)算法的优化、混合计算策略以及GPU算力的规模化部署,经典计算模拟该任务的时间成本大幅压缩。
从2021年实现关联采样只需304秒,到2022年完成无关联采样耗时15小时,再到2024年的最新优化方法,仅仅需要86秒。
那么,这是否说明量子计算并非想象中厉害呢?答案是否定的。
经典模拟虽可以通过利用底层线路的结构、局部性或极度受限的纠缠特征来延迟指数级成本的爆发,但这种策略的潜力终究会被耗尽。
量子系统天然在探索一个呈指数级增长的希尔伯特空间,当系统规模和线路深度继续增加时,经典超算必须对其进行近似压缩,其所需要的内存和算力资源最终还是会呈指数级增长。
长远来看,经典计算维持追赶的概率越来越低。
但也正是这种残酷的倒逼机制,使得竞争愈发具有科学价值。
量子实验不仅在推动量子硬件发展,也在推动经典张量网络算法、高性能计算(HPC)架构演进等。
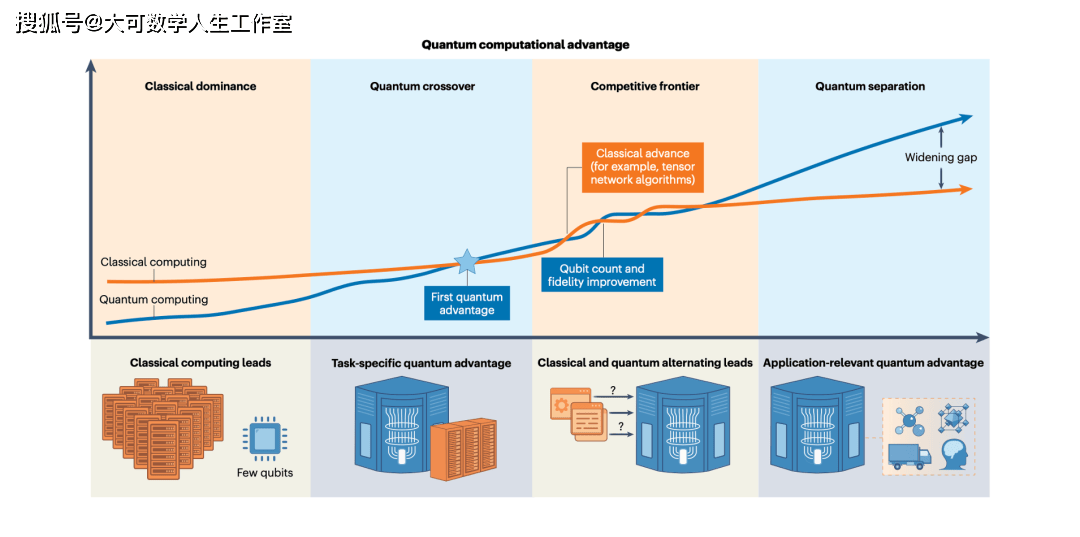
图:量子计算优势的发展
量子效用的四大门槛
截止目前,“量子效用”并没有统一答案。
不过文章指出,如果要实现量子效用,必须实现四个要求。
第一,计算优势必须超越精心设计的实例持续存在。
目前所有演示都是在“定制”问题上取得的,问题的困难性是被构造出来的,而不是问题本身固有的。
实用问题往往没有这么“听话”,它们的困难性分布不均匀,需要量子计算在更一般的条件下证明自己。
这意味着需要找到那些计算困难性内生于问题本身的类别。
第二,硬件发展需要从实验室驱动转向大规模工程驱动。
相干性、保真度、规模这些指标当然要继续提升,但关键瓶颈正在转移,比如工业能力:先进制造、封装、低温控制电子学、稀释制冷等基础设施。
这些不是单个实验室能搞定的,需要产业链级别的投入。
第三,算法必须和近期量子硬件兼容。
渐进加速在纸面上很好看,但在噪声和量子比特资源约束下很难兑现。
现实的方向是量子-经典紧密集成的工作流,以及针对特定任务的算法设计。
还有一个容易被忽视的问题:对于定义在经典数据上的问题,把输入编码成量子态、再把输出解码出来的开销,可能直接把计算收益吃掉。
所以早期量子效用大概率是端到端的、问题特定的。
第四也是最重要的一条,需要在逻辑量子比特层面展示量子优势。
当多个纠错后的量子逻辑比特能够支撑起超越经典算力极限范围的电路时,量子计算就可以从渐近承诺”变成“可操作能力”,这将会是一个历史性时刻。
不过,纵观全球产业界、资本市场、科研机构等都开始调整自己的预期了。
Gartner技术成熟度曲线把量子计算放在膨胀预期顶峰,提示短期内大规模的商业落地还不现实。
Forrester则相对乐观,但两者都认为,“实现量子优越性”已经不能再作为量子计算商业化的叙事支点。
总之,量子计算想要从工程化优势跳出来,实现具有持久实际影响的计算能力,就必须在计算复杂性理论、算法架构开发、底层硬件实验之间进行高通量的系统级协同设计。
对于深耕量子领域的科研人员、投资人等,剥离炒作并直面技术深水区,才是量子赛道最清醒的底色。
参考链接