下一代中性原子量子计算机,会长什么样?
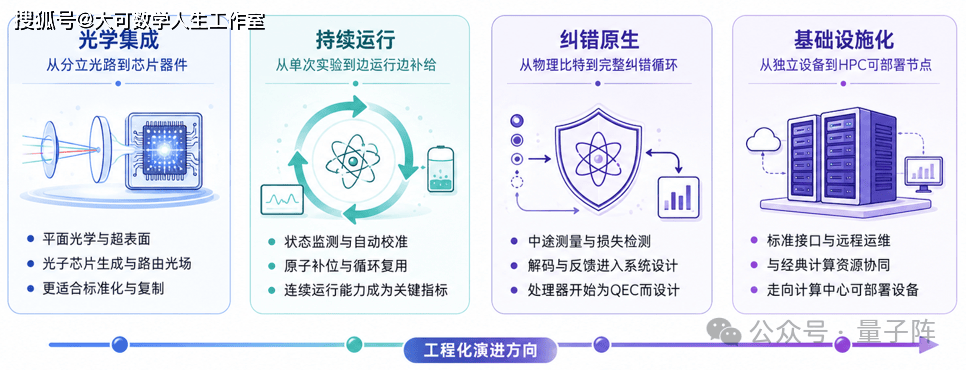
面向更大规模和容错计算,下一代机器的工程重点正在继续变化:光学要更集成,系统要能持续运行,硬件要从一开始就围绕纠错设计,并最终进入计算中心成为可调度的基础设施。
光学正在从平台走向芯片
中性原子计算机今天仍高度依赖自由空间光路,但所有功能都摆在光学平台上,越来越难支撑规模化。
2026年《Nature》报道利用全息超表面生成光镊阵列并捕获单颗锶原子:二维阵列超过100颗单原子,同时演示了36万个光阱的光场生成能力。
它说明原本由SLM、透镜组完成的部分波前塑形功能,可以向平面化光学器件迁移。
2026年8月,Pasqal又公布了更直接的工程尝试:单个光子芯片产生4个光阱并捕获4颗铷原子,原子寿命约27.5秒。
公司计划进一步把激光生成、路由和控制搬上芯片。
下一阶段并不是消灭自由空间光学,而是把最适合标准化、批量制造的功能逐步集成进去。
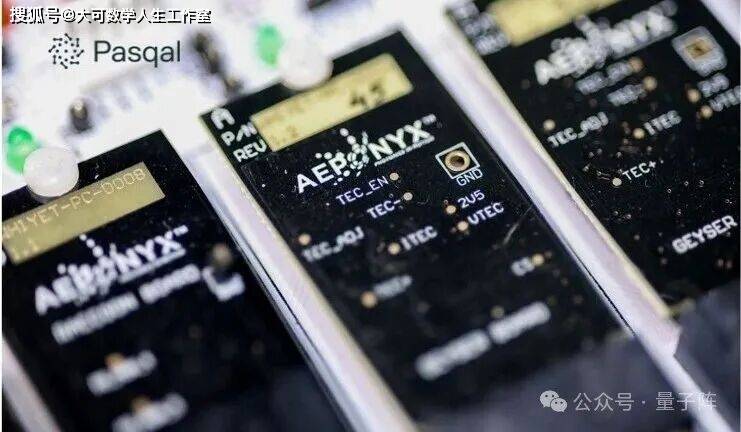
图1|Pasqal 2026“Qubit Control On-Chip”
来源:Pasqal
从单次实验,走向持续运行
真正的计算设备不能每做完一轮就停机重装。
2025年《Nature》展示了一套可持续补充原子的3000量子比特系统:通过两级光晶格输送原子储备,在不明显破坏已存储量子态的情况下持续补位,并把3000多颗原子的阵列维持超过2小时。
这类工作代表了一个重要变化:工程目标开始从“这一轮有没有成功”转向“机器能不能边运行、边补充、边恢复”。
自动校准、原子补位、状态监测和局部恢复最终要组合成一套持续运行能力。
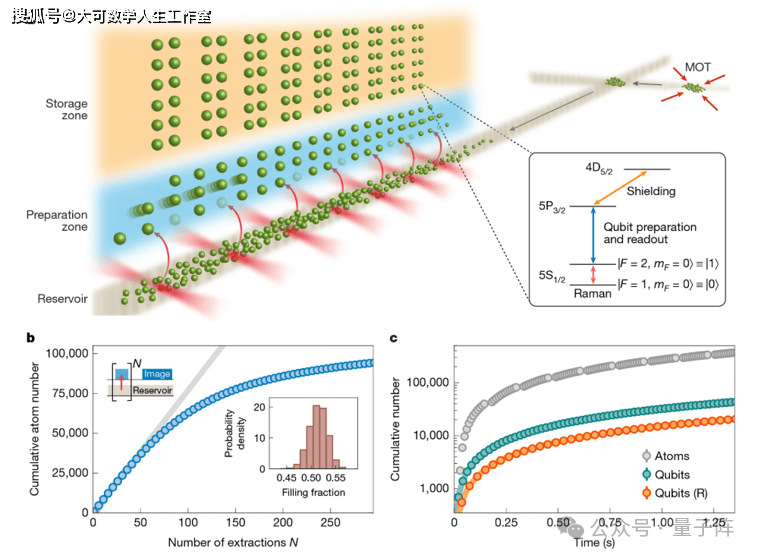
图2|中性原子处理器的连续原子供给架构
来源:Chiu et al., Nature 646, 1075–1080 (2025), Fig. 1.
机器开始为纠错而设计
更深层的变化发生在处理器架构本身。
下一代中性原子机器不能再把捕获、门、读出、搬运和解码分别做到最好,再在最后“外挂”一个纠错层。
它要从设计之初就考虑:辅助比特怎样测量,原子损失怎样识别,什么时候补位,测量结果怎样进入解码器,以及一轮纠错需要多长时间。
2026年《Nature》的可容错中性原子架构已经把这些环节放进同一处理器:多轮QEC、损失检测、机器学习解码、中途量子比特复用和逻辑操作共同运行。
下一代处理器的基本设计单位,正在从“一个物理量子比特”转向“一次完整、可重复的纠错循环”。
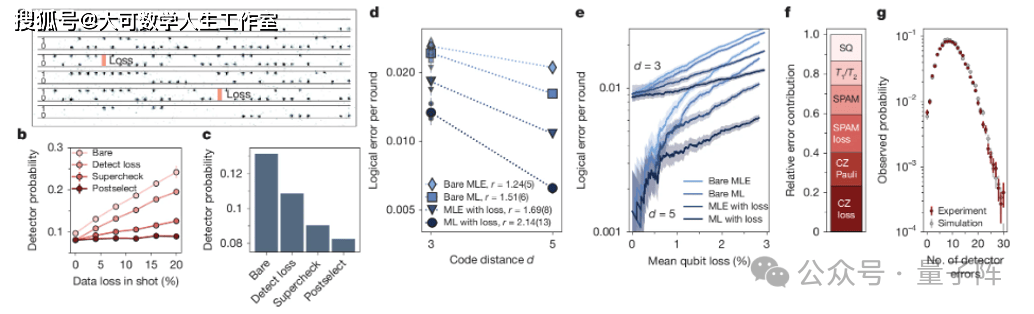
图3|纠错开始成为处理器的原生能力。
来源:Bluvstein et al., Nature 649, 39–46 (2026), Fig. 2.
从一台机器,到计算基础设施
当硬件真正产品化后,评价标准也会再次改变。
一台量子计算机不仅要能运输、安装和维护,还要能接入经典计算资源、被远程调度,并拥有稳定的软件和运维接口。
QuEra已将Gemini中性原子系统部署到HPC中心,并把未来产品明确定位为可在现有高性能计算基础设施中部署的量子加速节点。
这意味着终局并不是把一张大型光学平台装进机柜这么简单,而是让量子处理器像GPU或其他加速器一样,成为计算中心能够部署、运维、编排和升级的一类计算资源。
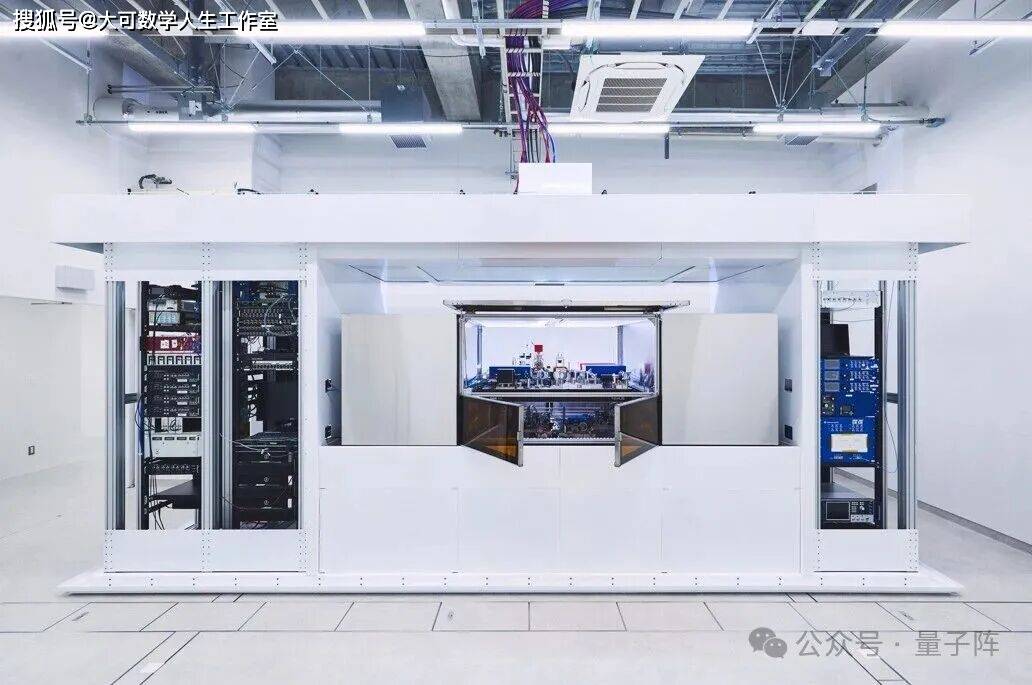
图4|QuEra Gemini门模型中性原子量子计算机部署于日本AIST G-QuAT设施
来源:QuEra Computing Media Kit.
从原子,到一套可扩展的计算系统
回看整个《拆解一台中性原子量子计算机》系列,我们真正拆开的可以归为三层:
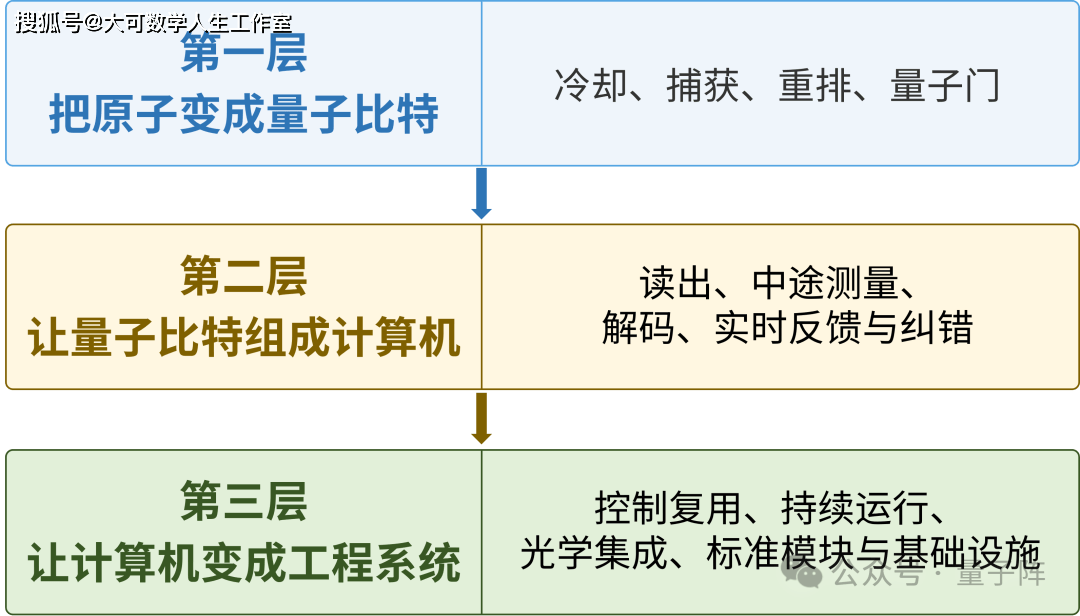
中性原子路线下一阶段真正比拼的,不再只是能捕获多少原子、门做到多高保真,而是谁能把原子、光学、电子控制、纠错和软件真正收敛成一套可持续运行、可扩展、可部署的计算系统。
*资料来源:
• A. Holman et al., Trapping of single atoms in metasurface optical tweezer arrays, Nature 649, 859–865 (2026).
• N.-C. Chiu et al., Continuous operation of a coherent 3,000-qubit system, Nature 646, 1075–1080 (2025).
• D. Bluvstein et al., A fault-tolerant neutral-atom architecture for universal quantum computation, Nature 649, 39–46 (2026).
• Pasqal, Brings Qubit Control On-Chip – Advancing the Path to Fault-Tolerant Quantum Computing at Scale (2026).
• QuEra Computing, Putting Quantum to Work for HPC Centers (official technology page).