原子没有意识,为什么一堆原子凑成人,就有了意识?
首先,原子本身没意识,但人有。
你可能会说:这不废话吗?原子是死的,人是活的,活的东西当然有意识。
可问题就在这:如果把你拆成一个一个的原子,每一个原子都跟路边石头没任何区别,既不会思考,也不会感受,连 “我存在” 都不知道。
怎么把这些原子按特定顺序拼起来,就突然拼出了 “我”,拼出了喜怒哀乐,拼出了能审视自己和宇宙的意识?
为了回答这个问题,人类想了几千年。
到了今天,答案其实已经越来越清晰了,但很多人反而不愿意信。
原因很简单:答案不够 “酷”。
很多人总觉得,意识这么玄妙的东西,肯定得配个玄妙的解释:量子力学、灵魂、高维空间、宇宙意识…… 越听不懂越觉得有道理。
尤其是彭罗斯和哈梅罗夫搞的那个 Orch-OR 理论,什么微管量子计算、客观坍缩,听着就高大上,完美满足了人们对 “意识神秘论” 的想象。
但很遗憾,在正经的神经科学圈子里,这个理论早就属于 “半似不活” 的状态了。
说它是 “尚待验证的假说” 都算抬举,本质上就是每一个环节都缺证据、全靠补丁硬撑的脑洞。
我们聊 “意识” 的时候,到底在聊什么?
很多人吵了半天意识,其实连 “意识是什么” 都没达成共识。
这也正常,“意识” 本来就是个日常用语,模糊得很,就像 “爱”“正义” 一样,每个人心里都有自己的定义。
但要聊科学,就不能这么模糊。
我们得先把概念拆清楚。
哲学上把意识问题分成两类:难问题(Hard Problem)和易问题(Easy Problem)。
什么是易问题?就是 “大脑是怎么做到识别面孔、集中注意力、回忆往事、控制身体的?” 这类问题。
这些问题虽然也难,但我们知道该怎么去研究,拆成神经机制一步步挖,早晚能搞明白。
什么是难问题?就是 “为什么我们会有主观体验?”,也就是 “为什么同样是处理信息,大脑处理就会有‘我感觉到了’的感受,而电脑处理就没有?” 这个问题。
难问题难在哪?难在它可能根本就是个伪问题。
有一派哲学家叫 “取消主义”,他们就说:所谓的 “主观体验”“感受质”,根本就是古人脑补出来的伪概念,就像以前的人以为燃烧是因为有 “燃素” 一样。
等我们把大脑的所有功能都搞清楚了,你就会发现,根本没有什么额外的 “难问题” 需要解释。
这话听起来很霸道,但其实很有道理。
你想想:你怎么知道自己有 “主观体验”?还不是靠大脑自己观察自己?你觉得 “我有感受”,本质上就是大脑的一个模块在报告另一个模块的状态。
等我们把这个内省机制搞清楚了,“难问题” 可能也就消失了。
当然,这个话题太哲学,咱们今天不深聊。
咱们退一步,就聊大家都能达成共识的部分:意识的那些功能性特征,比如理解信息、自我反思、连续的自我感、能做决策…… 这些东西,到底是怎么从一堆神经元里冒出来的?
在聊人脑之前,咱们可以先聊聊现在的大语言模型(LLM)。
很多人说 LLM 没有意识,这没错;但 LLM 的存在,给了我们一个绝佳的参照:同样是处理信息,它做到了什么,没做到什么,对比人脑,我们就能更清楚地看到 “意识的功能” 到底是什么。
目前普遍认为,称得上 “意识级别的功能”,大概有这么几个。
1.真正的 “理解” 能力
什么叫理解?不是死记硬背,而是能把一个概念放到整个知识网络里,消去歧义,准确知道它在不同语境下是什么意思。
比如我说 “苹果”,你第一反应是水果还是手机?取决于上下文。
如果前面在聊水果,那就是吃的苹果;如果在聊数码,那就是 iPhone。
这个 “消歧义” 的过程,就是理解的核心。
深度学习之父辛顿有个观点很精辟:所谓理解,就是用一个特征向量来代表一个概念,然后通过上下文不断地给这个向量 “收敛”,最后得到一个唯一的、精准的含义,能正确对应它和其他所有概念的关系。
从这个角度看,LLM 其实是有理解能力的。
它通过万亿参数的训练,把每个词都映射成了一个几百上千维的向量,向量之间的距离就代表语义的远近。
当你输入一句话,它就能通过上下文把每个词的向量调整到最准确的位置,然后输出下一个词。
很多人说 “LLM 只是随机鹦鹉,根本不懂自己在说什么”,这个观点早就过时了。
Anthropic(安特罗匹克) 之前有篇论文,专门研究了大模型的推理过程,发现模型内部确实有对应的推理回路,不是瞎蒙的。
如果它真的完全不懂,那推理题的正确率应该跟瞎猜差不多,但实际上它能做对很多,只是对词元的顺序比较敏感而已。
当然,LLM 的理解有缺陷。
比如它没有身体,没法亲身感受 “疼”“烫”“开心” 是什么感觉,所以在涉及具身体验的话题上,它的理解就很空洞。
这不是架构不行,是它缺了身体的输入,也就是 “符号接地” 问题。
2.元认知与自省能力
简单说就是:你知道自己在想什么,知道自己不知道什么,能反思自己刚才想得对不对。
这一点上,LLM 就差点意思了。
现在的推理模型虽然能写思维链(CoT),一步一步想问题,但它其实不知道自己 “内部” 是怎么想的。
它写出来的推理过程,和它实际计算的过程,并不完全一致。
它只能通过输出的文字来 “看” 自己之前想了啥,每输出一个词元,内部的中间状态就损失了一部分。
但人脑不一样。
人脑可以直接 “读取” 自己内部的表征,你不用把想法说出来,就知道自己在想什么,还能自己评判自己想得好不好。
这种对自身思维状态的直接感知,是目前 LLM 还做不到的。
3.同一性:连续的 “自我”
你知道昨天的你和今天的你是同一个人,你有从小到大的记忆,你有稳定的性格和偏好,你是从第一人称视角看世界的。
这一点 LLM 就更没有了。
你每次跟它对话,它都是 “全新” 的,上下文窗口就是它全部的临时记忆,对话一关,它就 “失忆” 了。
你甚至可以随便编一段它之前说过的话,它大概率会以为真是自己说的,当然现在最新的模型已经能一定程度区分预填充内容了,但本质上还是没有持续的自我。
4.主观体验
这个就是咱们开头说的 “难问题” 了,没法用功能描述,所以今天咱们就不多说了。
总结一下:我们今天要聊的 “意识怎么来的”,其实就是聊:大脑这坨由神经元和突触组成的网络,是怎么实现 “理解、自省、自我感” 这些功能的?
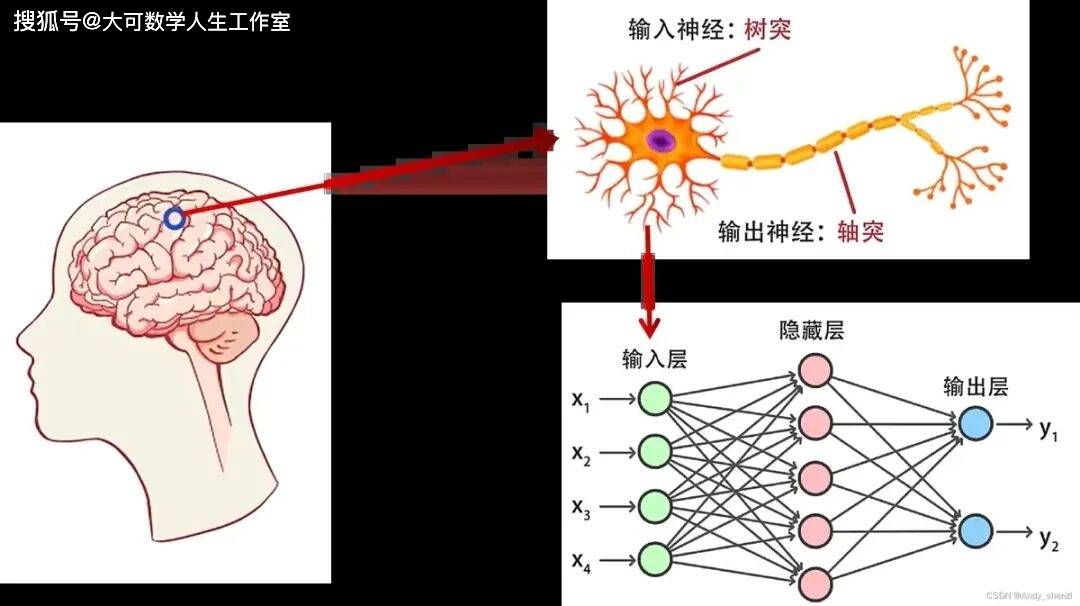
很多人喜欢用一句话打发:“这是涌现现象,复杂到一定程度就有了。
”
这话没错,但太敷衍了。
就像问 “房子怎么来的”,你说 “砖头堆多了就成房子了”,等于没说。
我们想知道的是:砖头是怎么砌成墙、怎么架上梁、怎么装上门窗,最后变成能住人的房子的。
今天咱们就从神经动力学的角度,看看这堆 “神经元砖头”,是怎么搭出 “意识” 这栋房子的。
很多入门科普会把大脑画成一条流水线:眼睛看到东西,信号传给视神经,再传到初级视觉皮层,然后一层层往上加工,最后输出一个结果。
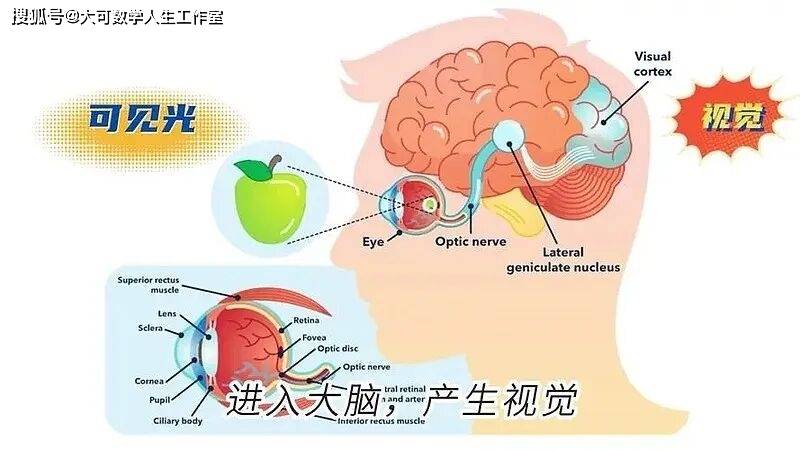
就像工厂加工零件,从进料口进去,经过一道道工序,最后出来成品。
但这根本不是大脑的工作方式。
你想想,你大部分时间并不是在被动地等外界刺激。
你会走神、会胡思乱想、会在心里自言自语、会回忆昨天发生的事,这些都不需要外界输入,大脑自己就在那持续活动。
解剖学也证明了这一点:大脑新皮质里,到处都是循环连接,信号不光是从前往后传,还会从后往前传,同级之间也互相传。
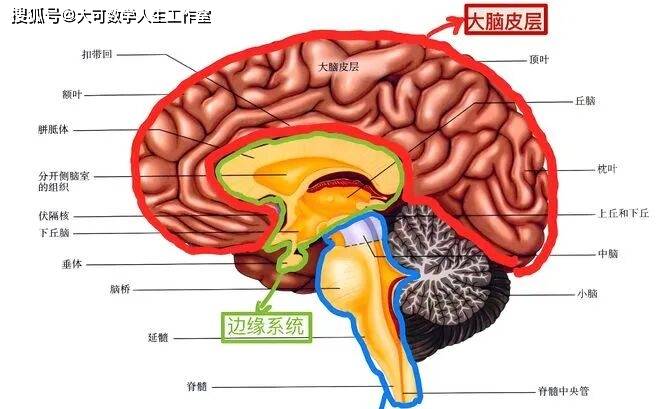
整个网络是个巨大的闭环,而不是单向的流水线。
这种循环连接有什么用?用处大了:它能让大脑维持稳定的内部状态。
单个神经元的活动很短暂,一次放电也就几毫秒,突触信号也很快就消失了。
但我们的一个想法、一段记忆,能持续几秒、几分钟甚至更久。
这是怎么做到的?
靠的就是循环连接形成的 “吸引子”。
“吸引子” 是从动力系统理论借来的词。
你可以把大脑的整体状态想象成一个高维空间里的一个点,这个点会随着神经元的放电不断移动。
如果它移动到某个区域,就会像掉进坑里一样,在里面来回转,不容易跑出去,这个 “坑” 就是吸引子。
一个想法、一段记忆,本质上就是神经活动掉进了一个对应的吸引子里。
比如你看到 “猫” 这个词,视觉信号激活了脑子里代表 “猫” 的那一群神经元。
这群神经元之间有很强的循环兴奋连接,一旦被激活,就能自己 “Hold 住” 高频放电,即使外界的字消失了,你脑子里还能想着 “猫”,持续好几秒。
这就是一个记忆吸引子。
再比如你发呆、什么都不想的时候,大脑也不是关机了,而是掉进了另一个吸引子:所有神经元都低频随机放电,也就是默认模式网络的状态。
你可能会问:那 “自我意识” 呢?也是吸引子吗?
没错。
所谓的 “自我”,本质上就是大脑里一个特殊的概念模型,跟 “猫”“桌子” 这些概念没有本质区别,只不过这个模型是用来描述 “我自己” 的,包含了我的记忆、我的性格、我的身体状态、我的社会关系……
这个 “自我模型” 对应的吸引子,就是我们 “自我感” 的动力学基础。
你之所以觉得 “我” 一直都在,是因为这个吸引子一直稳定地存在于你的皮层里,只要你醒着,它就处于激活状态,不会轻易消失。
说到吸引子,就不得不提一个人:约翰・霍普菲尔德(John Hopfield)。
1982 年,霍普菲尔德发表了一篇经典论文,提出了后来以他名字命名的 Hopfield 网络。
这是最早的循环神经网络之一,核心就是吸引子动力学。
Hopfield 网络能干什么?最经典的就是联想记忆。
比如你给它看一张模糊的数字 “3”,它能自动把它还原成清晰的 “3”;你给它半张人脸,它能补全整张脸。
为什么?因为每个记忆就是一个吸引子。
模糊的输入,就像把系统放在了吸引子的斜坡上,它会自动滑到坑底,也就是最接近的记忆状态。
人脑的记忆也是这么工作的。
比如你看到一个背影,觉得特别熟,想了半天,哦,是小学同学。
这个过程,就是你的大脑从一个模糊的输入,慢慢收敛到对应的记忆吸引子上。
以前我们总说 “记忆是存储在大脑里的”,其实不对。
记忆不是像文件一样存在某个地方,而是整个网络的一种活动模式。
提取记忆的过程,就是让网络掉进对应的吸引子的过程。
这个观点彻底改变了我们对记忆的理解。
而且 Hopfield 网络还有个特点:容错性强。
哪怕一部分神经元坏了,只要不是太多,网络依然能正确提取记忆。
这也和人脑很像,大脑每天都有神经元死亡,但我们的记忆不会突然消失。
你看,一个简单的循环网络模型,就能解释这么多记忆的特性。
而这一切,都是经典的动力学,和量子没有任何关系。
听到这你可能觉得:这不就是换了个高大上的词说 “记忆就是神经持续放电” 吗?有什么新鲜的?
别急,吸引子模型厉害的地方在于,它能精准地解释很多实验现象,还能定量预测。
咱们来看一个经典的工作记忆模型。
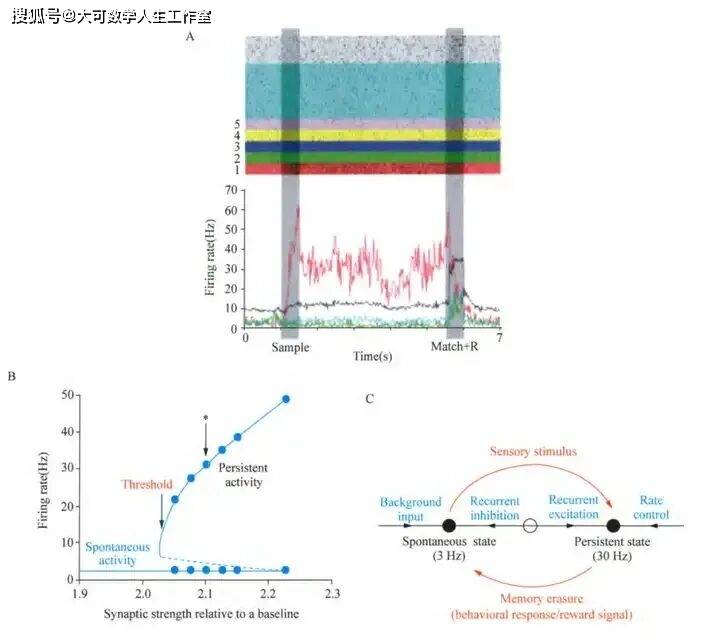
科学家做过一个仿真:假设有五个神经元集群,每个集群负责编码一个物体。
当给一个短暂的刺激,比如闪过一个物体,对应这个物体的集群就会开始持续高频放电,把信息维持住,其他集群则被抑制。
这个活动会一直持续,直到给一个 “清空” 信号,网络才回到基线状态。
这个模型有个很有意思的预测:记忆不是 “逐渐模糊” 的,而是 “要么有,要么没有”。
为什么?
因为循环连接的强度有个临界值,也就是 “分岔点”。
低于这个阈值,你怎么刺激都留不住记忆,信号很快就散了;超过这个阈值,网络就会突然进入稳定的持续放电状态,记忆一下子就 “立住” 了。
就像开灯,按一点不亮,按到某个位置 “啪” 一下就亮了,没有中间的半亮不亮。
实验也确实证明了这一点:人的工作记忆,确实是全或无的。
要么你清楚地记得,要么你完全忘了,不会有 “记得一半” 的状态。
那吸引子为什么能稳定?因为有 “恢复力”。
系统一般有两个稳定状态:低放电的自发态,和高放电的记忆态。
在低放电状态,稍微有一点扰动,比如某个神经元不小心多放了一下电,负反馈机制就会把它压下去,回到平静。
在高放电状态,循环兴奋的力量足够强,能抵抗噪声,维持放电;同时又有抑制性神经元和突触饱和机制 “封顶”,不会让兴奋越演越烈,最后变成癫痫。
这就像一个不倒翁,你推它一下,它晃两下又回到原位。
要让这个系统稳定工作,生物层面上有两个关键的 “设计”。
第一个是速度的平衡。
如果正反馈(兴奋)和负反馈(抑制)速度一样快,会怎么样?会振荡。
就像你调空调,如果制冷太快,温度一下就低了,然后又马上停,温度又升上去,来回晃。
大脑里 AMPA 受体介导的兴奋和 GABAa 受体介导的抑制都很快,凑在一起就会产生伽马波段的快速振荡。
这种振荡在处理信息的时候有用,但用来维持记忆就不行了,太不稳定。
那怎么办?大脑用了 NMDA 受体来 “减速”。
NMDA 受体的动力学时间常数特别长,有 50 到 100 毫秒,比 AMPA 和 GABAa 慢得多。
它就像一个缓冲器,把快速的波动给平滑掉了,让记忆状态变得稳稳的。
这个模型有个非常明确的预测:NMDA 受体对工作记忆至关重要。
后来科学家在猴子身上做实验,用药物阻断 NMDA 受体,猴子的工作记忆果然就崩了,跟预测的一模一样。
第二个是兴奋与抑制的平衡(E/I 平衡)。
光有稳定还不够,记忆还得有选择性。
你总不能想一件事的时候,所有记忆都跑出来吧?
这就靠抑制性中间神经元了。
一个神经元集群兴奋的时候,会通过侧向抑制,把周围其他的集群都压下去。
就像选美比赛,一个选手得分高了,就把其他人的分数往下压,保证只有一个胜出者。
而多巴胺、血清素这些神经调质,就像调节器,能精细调整兴奋和抑制的强度,让系统更能抵抗干扰。
比如你注意力集中的时候,多巴胺水平升高,就能增强目标神经元的活动,同时抑制无关的干扰,让你更专注。
你看,就这么一套简单的机制:循环连接 + NMDA 慢兴奋 + 侧向抑制,就实现了 “维持单个想法” 的功能。
那如果我们想做决策,在两个想法之间选一个呢?
也不用什么新机制,还是这套东西,换个玩法就行。
认知科学家特别喜欢用一个叫 “二择一迫选任务” 的实验来研究决策。
怎么玩呢?给猴子看一堆随机运动的光点,其中有一小部分朝同一个方向动,要么左要么右,猴子要判断出这个主方向,用眼睛看向答案。
调整同向运动光点的比例,就能控制难度。
方向越明显,越容易;光点完全随机的话,就只能瞎猜。
做出这个经典实验的,是威廉・纽瑟姆(William Newsome)和迈克尔・沙德伦(Michael Shadlen)。
他们记录了猴子大脑里后顶叶和前额叶的神经元放电,发现了一个很有意思的现象:神经元的放电频率,不直接反映刺激的强度,而是反映猴子 “即将做出什么选择”。
哪怕光点完全不动、纯随机,只要猴子心里猜了 “右”,代表 “右” 的神经元放电就会飙升,代表 “左” 的就被压下去。
这个过程,用一个双稳态吸引子模型就能完美模拟。
模型非常简单:两个兴奋性神经元集群,一个代表左,一个代表右,中间通过抑制性神经元互相竞争。
视觉信号会同时输入给这两个集群。
我们来看看模拟的过程:
一开始,输入信号出现,两边的神经元都开始同步放电,频率差不多。
这就像大脑在收集证据,两边都有道理,暂时分不出高下。
但因为网络里有噪声,总有一边会稍微快一点点。
就像两个势均力敌的选手拔河,总有一方先占一点上风。
别小看这一点点上风,在非线性动力学里,优势会被迅速放大。
几百毫秒之后,一边的放电直接起飞,另一边则被彻底压制,再也抬不起头。
于是,决策就做出了。
这个模型能解释很多现象:
比如,证据越强(同向光点越多),决策越快越准。
因为一边的优势一开始就很大,很快就能把另一边压下去。
比如,纯随机的时候,也一定会做出选择,不会一直卡在那。
因为噪声总会让一边先出头,然后迅速决出胜负。
再比如,状态空间里,即使初始条件完全一样,最后也会随机落入左或右两个吸引子,概率各 50%。
这就是 “瞎猜” 的神经基础。
后来科学家还发现,决策的信心,也和这个过程有关。
如果证据很强,决策做得很快,信心就高;如果证据很弱,决策做得慢,信心就低。
因为证据强的时候,吸引子收敛得快,大脑能 “感觉到” 收敛的速度,从而产生信心。
你看,同样一套吸引子网络,给一个输入,它就是工作记忆;给两个互相竞争的输入,它就是决策器。
是不是很优雅?
大自然根本不需要为每个功能单独设计一套机制,一套基础玩法,变变参数就能干不同的活。
当然,真实的大脑比这复杂得多。
大脑不只有这种二选一的 “点吸引子”,还有能表征连续变量的 “线吸引子”。
比如编码头部转动的角度、眼睛看的方向,就得是连续的,不能只有左和右两个状态。
还有更复杂的 “混沌吸引子”,用来处理更复杂的认知活动。
但基本的原理都是一样的:靠循环连接维持状态,靠抑制性连接实现竞争和选择。
讲到这,我们已经解释了 “维持想法” 和 “做出决策” 是怎么来的。
接下来咱们聊聊大家都深有体会的一件事:为什么人的短期记忆力这么差?
你肯定有过这种体验:别人跟你说一串电话号码,你挂了电话就忘了;去超市买东西,列了五样,到了超市肯定忘一样;同时想三件事,想着想着就漏了一件。
这就是工作记忆的限制。
著名的米勒法则说,人的工作记忆容量是 7±2 个组块;后来更严谨的研究认为,其实只有 4 个左右。
4 个,这也太少了吧?电脑内存都按 G 算了,我们大脑这么厉害,怎么工作记忆才这么点?
今天咱们就从神经动力学的角度,给你讲清楚这背后的原因。
首先得明白:大脑是怎么同时存多个记忆的?
刚才说的单个吸引子,只能存一个想法。
要存好几个,怎么办?
很简单,让不同的神经元集群轮流放电就行。
比如,集群 A 先放电,代表第一个东西;然后 A 歇会,集群 B 放电,代表第二个;然后 B 歇会,C 放电;然后再回到 A。
就像舞台上的演员,一个个轮流上场,观众就能同时记住好几个角色。
这个循环往复的过程,在相空间里画出来就是一个圈,数学上叫 “极限环”。
这个圈越大,能装下的记忆项就越多。
那工作记忆容量由什么决定呢?
两个关键因素:
第一个,同一个神经元集群,两次放电之间的最大间隔。
简单说就是,一个演员下场后,最多能歇多久再上场,观众还能记得他。
这个间隔主要由突触的短时程抑制决定。
突触就像肌肉,用了一次会疲劳,需要歇一会才能恢复。
如果间隔太长,突触恢复太多,之前的激活痕迹就没了,记忆也就断了。
第二个,两个不同集群放电的时间间隔。
也就是一个演员下场,下一个演员上场,需要多久。
这个时间主要由抑制的恢复时间决定。
一个集群兴奋的时候,会把其他集群都抑制住。
等它下场了,抑制不会马上消失,得慢慢消退,下一个集群才能重新兴奋起来。
所以,工作记忆容量大概就等于 “最大间隔” 除以 “切换间隔”。
就像一节课 45 分钟,每个同学上台讲 5 分钟,那一堂课就能上 9 个同学。
那为什么人类的容量只有 4 个左右?
我们来拆解一下影响因素。
先看 “最大间隔”,它取决于突触恢复的快慢。
突触恢复越慢(时间常数越大),最大间隔就越长,容量就越大。
但这是把双刃剑。
突触恢复太慢,意味着你切换想法就会变慢,反应迟钝。
比如别人跟你说句话,你半天反应不过来,因为上一个想法还没消退,新的进不来。
再看 “切换间隔”,它取决于神经元的兴奋速度。
神经元放电越快,从抑制中恢复得越快,切换间隔就越短,容量就越大。
但神经元放电快也有代价:费电。
你可别小看大脑的功耗。
大脑只占体重的 2%,却消耗了全身 20% 的能量。
其中大部分都用在钠钾泵上,每次动作电位之后,都要把跑出去的钠离子泵回来,跑进来的钾离子泵出去,这个过程极其耗能。
如果让神经元放电速度翻倍,大脑可能直接就 “过热死机” 了。
所以,演化是在 “容量” 和 “速度 / 能耗” 之间做了个权衡。
4 个组块,不多不少,正好够用,又不至于太费电、反应太慢。
最早研究工作记忆的是乔治・米勒,1956 年他发表了著名的《神奇数字 7±2》,说人的短时记忆容量是 7 个左右的单元。
但后来的研究发现,米勒其实高估了。
真正的纯工作记忆容量,也就是不借助组块的话,大概只有 4 个。
为什么会有差异?因为米勒那个年代的实验,没有严格控制组块。
被试会不自觉地把字母拼成单词,变成组块,所以看起来容量大。
那组块是什么?本质上就是把多个信息打包成一个吸引子。
本来四个字母是四个吸引子,拼成一个单词,就变成一个吸引子了,自然就能省出空间装更多东西。
高手和普通人的区别,很大程度上就是组块能力。
比如象棋大师,看一眼棋盘就能记住所有棋子的位置,不是因为他工作记忆大,而是他能把棋盘分成好几个熟悉的阵型,每个阵型是一个组块。
但不管怎么组块,同时活跃的组块数,还是逃不出 4 个左右的限制。
这是大脑的硬件决定的。
还有个有意思的现象:人的工作记忆容量,从儿童到成年是逐渐增加的,到老年又下降。
这和突触的发育是对应的。
儿童的突触恢复速度快,但持续时间短,所以工作记忆容量小;成年后突触动力学最优化,容量达到顶峰;老年时突触功能退化,容量又下降了。
一切都有迹可循,没有什么神秘的。
那有没有办法真正增加工作记忆容量?
理论上有两个办法:
一个是让突触恢复更慢,延长最大间隔。
但刚才说了,会导致反应迟钝。
另一个是让神经元放电更快,缩短切换间隔。
但刚才也说了,能耗和生物硬件不允许。
神经元膜上的离子通道开关需要时间,膜电容也不是零,改变电位需要时间,这些都是物理极限,不是想快就能快的。
对比一下就知道了:电脑的 SRAM 内存,读写速度是纳秒级的,只要通电就不会丢信息;而人脑的短时记忆,靠的是持续放电维持,毫秒级的速度,还特别容易忘。
这就是生物硬件的局限。
但反过来想,就这么慢的元件,能搭出能思考、能创作的大脑,才更神奇不是吗?
讲到这,我们说了记忆,说了决策,说了工作记忆的限制。
但还有个问题:大脑既要能稳定维持想法,又要能灵活切换想法,这两者是矛盾的啊。
大脑是怎么做到既稳定又灵活的?
答案是:让大脑工作在 “临界态”。
你有没有想过:为什么大脑有时候特别灵光,思路清晰,反应飞快;有时候又昏昏沉沉,脑子像灌了浆糊?
很大程度上,取决于你的大脑是不是处在 “临界态”。
什么是临界态?
这是统计物理学里的概念。
简单说,就是一个系统在 “有序” 和 “无序” 之间的那个临界点。
比如水,低于 0 度是冰,固态,有序,但死板;高于 0 度是水,液态,无序,但灵活;0 度的时候,就是临界态,既能结冰又能融化,既有秩序又有灵活性。
大脑也是一样。
如果神经兴奋性太低,就处于 “亚临界态”。
就像一潭死水,扔个石头进去,涟漪没扩散多远就没了。
信号传不远,神经元之间联动差,反应慢,思路打不开。
这对应的就是昏昏欲睡、麻醉、深度睡眠的状态。
如果神经兴奋性太高,就处于 “超临界态”。
就像一堆干柴,一点火星就整个烧起来,微小的刺激就能引发全局同步放电。
这就是癫痫,整个大脑乱成一团,虽然同步了,但没有任何有效信息。
只有在两者之间的临界点,也就是兴奋和抑制刚刚好平衡的时候,大脑才处于最佳状态:信号既能传得足够远,又不会失控;既能稳定维持想法,又能灵活切换。
这就是 “大脑临界态假说”。
临界态这个概念,最早是物理学家巴克(Per Bak)提出来的,叫 “自组织临界性”。
他最经典的例子就是沙堆。
你往桌子上慢慢倒沙子,沙堆会越来越高。
到了某个高度之后,再倒沙子,就会发生崩塌。
崩塌有大有小,小的就是几粒沙子滑下来,大的就是半边沙堆都塌了。
统计一下就会发现:崩塌的大小和发生的频率,符合幂律分布。
也就是崩塌越大,发生的概率越低,而且是严格的数学比例。
这就是自组织临界态。
沙堆会自动维持在那个临界点,既不会太矮(塌不起来),也不会太高(一倒就全塌)。
后来科学家发现,大脑里的神经活动,也是这样的。
神经元的放电 “雪崩”,也就是一群神经元一起放电,大小也符合幂律分布。
小雪崩很多,大雪崩很少,和沙堆一模一样。
这就是大脑处于临界态的直接证据。
为什么会这样?
因为大脑也是一个自组织系统,通过突触可塑性,自动把自己调整到临界点。
那大脑具体是怎么维持在临界态的呢?
主要靠两套机制。
第一套是神经调质的负反馈调节。
多巴胺、去甲肾上腺素这些东西,对大脑兴奋性的影响是个倒 U 型曲线。
浓度太低,大脑没精神;浓度太高,大脑太兴奋。
只有在某个最优浓度,才刚好在临界态。
大脑会自动调节这些神经调质的分泌。
如果太兴奋了,就抑制一下;如果太消沉了,就提升一点。
就像空调自动控温一样,把温度维持在设定值附近。
第二套是突触可塑性机制。
突触不是一成不变的,它会根据使用情况调整强度。
用得多了就变强,用得少了就变弱。
这个过程会自动推着网络向临界态演化。
比如,如果网络太兴奋,突触就会整体下调一点强度,让兴奋降下来;如果太沉寂,突触就会增强一点,让兴奋提上去。
就像自动音量控制,声音大了就调小,声音小了就调大,始终保持在合适的水平。
处在临界态的大脑,有什么好处?
第一个好处:相关长度发散,信息传得远。
什么叫相关长度?简单说就是两个神经元之间活动的关联程度。
在亚临界系统,离得远的神经元,活动基本没关系,各干各的,所以相关长度很短。
在超临界系统,所有神经元都同步放电,看起来好像相关性很强,但那是整体都一样,不是信息传递。
只有在临界态,神经元之间的相关性会随着距离增加,按幂律慢慢下降,而不是指数下降。
这就叫 “相关长度发散”。
意味着什么?意味着一个地方的信号,能影响到很远的地方,大量神经元都能参与到信息处理中来。
就像在临界态的水里,一个地方的波纹能传到很远;而在冰里,波纹传不远;在沸腾的水里,波纹乱成一团,也传不了信息。
第二个好处:标度不变性,长时记忆更好。
临界态的系统,还有个特点叫 “标度不变性”,也就是分形特征。
放大看和缩小看,结构是一样的。
大脑的神经活动也是这样。
从毫秒级到秒级,从局部到全局,活动的模式都是相似的,有长程时间相关性。
这种特性,让大脑的长时记忆和短时记忆能更好地衔接,信息处理的效率更高。
甚至有研究认为,很多天才的大脑,可能就是更接近临界态。
所以他们思维更活跃,联想更丰富,能想到别人想不到的东西。
但代价就是,也更容易得精神疾病。
因为离临界态太近,稍微偏一点就超临界了,比如精神分裂、癫痫,都和临界态偏移有关。
这就是演化的权衡。
没有完美的大脑,聪明和稳定,不可兼得。
当然,临界态假说不是万能的,它不能解释所有的意识现象,但它给了我们一个非常简洁的框架,去理解大脑为什么这么工作,也能解释很多脑疾病。
比如癫痫,就是大脑跑到超临界态了;比如抑郁症、注意力缺陷,可能就是大脑偏亚临界了。
很多治疗方法,本质上都是把大脑调回临界态。
而且这个理论还做出了很多可验证的预测,很多都已经被实验证实了。
现在越来越多的研究认为,处于临界态,是生物神经网络实现最优计算能力的必要条件。
好了,到这里,我们用吸引子、决策网络、工作记忆、临界态这几个概念,已经能解释意识的大部分核心功能了:
靠循环连接和吸引子,我们能维持想法和记忆;
靠吸引子之间的竞争,我们能做决策;
靠突触动力学的权衡,我们有了有限但够用的工作记忆;
靠临界态调节,我们的大脑既稳定又灵活。
所有这一切,用的都是最经典的神经网络动力学,没有量子什么事,也没有什么超自然的力量。
就是一堆普通的原子,组成了神经元,神经元组成了网络,然后通过精巧的动力学机制,涌现出了意识的种种功能。
你可能会说:等等,你说的这些都是 “功能”,但 “主观体验” 呢?那个难问题呢?
说实话,目前没人能完整回答。
但我们有理由相信,当我们把所有功能都搞清楚了,难问题可能也就不是问题了。
就像以前的人不知道 “生命是什么”,觉得生命有 “活力”,是神秘的。
等我们搞清楚了 DNA、细胞、新陈代谢,就发现根本没有什么 “活力”,就是普通的物理化学反应。
意识很可能也是一样。
它不是什么额外加在物质上的 “灵魂”,就是物质本身复杂到一定程度之后的表现。
讲到这,肯定有人不服:那彭罗斯的 Orch-OR 理论呢?那么多大科学家都支持,难道都是错的?
还真别说,这个理论,从根上就漏洞百出。
接下来咱们就好好扒一扒这个著名的 “量子意识” 理论,看看它到底有多不靠谱。
彭罗斯,大数学家、物理学家,诺贝尔奖得主,名头够大吧?
哈梅罗夫,麻醉科医生,对微管有研究。
这两个人凑到一起,搞出了一个 “协调客观还原理论”,也就是 Orch-OR,号称用量子力学解释意识。
这个理论的逻辑链条是这样的:
意识的难问题用经典物理解释不了→2. 人脑肯定是超图灵的,能做图灵机做不到的事→3. 所以人脑里一定有量子计算机制→4. 这个机制就在神经元的微管里,靠量子引力引发波函数坍缩,产生意识。
听起来是不是很顺?但实际上,这链条的每一环,都断得不能再断了。
咱们一环一环来拆,先聊聊这个理论的来龙去脉。
Orch-OR 的诞生,大概是在 1990 年代初。
彭罗斯先在《皇帝新脑》这本书里提出了 “人脑超图灵”“量子引力产生意识” 的想法,然后哈梅罗夫看到了,觉得微管可以作为量子计算的载体,两人一拍即合,1996 年正式提出了 Orch-OR 理论。
理论刚出来的时候,确实引起了不小的轰动。
毕竟彭罗斯是诺奖级别的人物,说的话分量重,而且量子 + 意识的组合,太对大众的胃口了。
但很快,批判就来了。
第一环:人脑真的是 “超图灵” 的吗?
彭罗斯认为,人类能通过 “直觉” 看出哥德尔不完备定理里的那个真命题,而形式系统做不到,所以人类心智超越了图灵机。
这个说法,早在几十年前就被哲学家普特南批过了:它默认了 “人类心智是一致的”,也就是我们不会自相矛盾。
但这个前提根本不成立。
人类本来就不是逻辑一致的。
我们会犯错误,会自相矛盾,会相信互相冲突的观点。
我们所谓的 “看出真理”,很多时候就是瞎蒙,然后事后找补。
而且,就算人类能 “看出” 某个命题是真的,也不代表超越了图灵机。
图灵机不能证明的命题,你也不能证明,你只是 “相信” 它是真的而已。
实际上,目前没有任何证据表明,人脑能解决任何图灵不可计算的问题。
所有说 “人脑超图灵” 的,都是把 “直觉”“灵感” 这种东西,当成了 “超计算能力”,本质上就是不懂计算理论的脑补。
很多人还喜欢举例子:“湍流、蛋白质折叠、黑洞奇点,这些都是超图灵的,人脑肯定也是。
”
这是把 “计算复杂” 和 “超图灵” 彻底搞混了。
这些东西,是计算起来很复杂,属于 NP 难甚至更难的问题,但它们依然是图灵可计算的。
也就是说,图灵机可以算,只是算得慢,需要很长时间,不是不能算。
而超图灵,是指能解决图灵机原则上都解决不了的问题,比如停机问题。
这完全不是一回事。
蛋白质折叠再难,我们也能用计算机模拟,只是精度和速度的问题;湍流再复杂,也能用数值方法算。
它们都是经典物理过程,都是图灵可计算的。
拿这个说人脑超图灵,就是不懂计算理论的表现。
第二环:就算人脑厉害,就一定是量子计算吗?
这又是个巨大的跳跃。
很多人有个误区:觉得量子计算比经典计算厉害,什么都能算。
其实不是。
量子计算只是在特定问题上有优势,比如大数分解、量子模拟,它能算的问题,经典计算机也能算,只是慢一点。
量子计算依然是图灵可计算的,根本不是什么 “超图灵”。
彭罗斯也知道这一点,所以他只能扯到 “量子引力”,说现在的量子力学不完备,量子引力里有未知的机制,能实现超图灵计算。
这就相当于:“我解释不了,所以肯定有个更高级的东西,这个东西还没被发现,所以我是对的。
”
典型的 “空隙中的上帝” 论证:科学解释不了的地方,就塞进去一个神秘的东西。
第三环:微管里真的能进行量子计算吗?
这是最扯的一环,也是被锤得最狠的一环。
彭罗斯和哈梅罗夫说,神经元里的微管,是量子计算的单元,里面的电子能处于叠加态,还能全局纠缠,每 25 毫秒坍缩一次,产生意识。
但稍微懂点量子计算的人都知道,量子比特对环境极其敏感。
一点点热噪声、一点点干扰,都会让量子态退相干,也就是量子叠加态消失,变成经典状态。
量子计算机要工作,得接近绝对零度,还要真空屏蔽,才能维持极短时间的相干。
那大脑里是什么环境?37 度,温暖,潮湿,充满了各种分子热运动,嘈杂得不行。
2000 年,物理学家马克斯・泰格马克(Max Tegmark)在《物理评论 E》上发表了一篇论文,直接给了 Orch-OR 致命一击。
他详细计算了大脑环境下微管的退相干时间,结果是 10^-13 秒。
这个时间有多短?这么说吧,你眨一下眼睛的时间,大概是 0.1 秒,也就是 10^-1 秒。
退相干时间比眨眼睛短一万亿倍。
这么短的时间,能干什么?什么都干不了。
量子态还没来得及做任何计算,就已经坍缩了。
这就是著名的 “温暖、潮湿、嘈杂” 问题,也是 Orch-OR 理论最核心的死穴。
那哈梅罗夫他们怎么回应的呢?
他们开始打补丁。
2002 年,他们发了篇回应,说泰格马克算的是 “稻草人模型”,他们的模型里微管的分离距离更小,只有 2 纳米,不是 24 纳米,所以退相干时间能延长 7 个数量级,到 10^-12 秒。
哦,0.000000000001 秒。
那还是不够啊!差着好多个数量级呢。
然后他们又接着打补丁:说微管周围有德拜层,能屏蔽热噪声;还有有序水和肌动蛋白凝胶,能进一步隔离噪声。
但这些 “保护机制”,全都是假设,没有任何实验证据。
而且就算有这些,算下来退相干时间还是远远不够做量子计算。
补丁越打越多,漏洞也越来越多。
2009 年,又一波批判来了。
杰弗里・莱默斯(Jeffrey Reimers)和南希・麦克米什(Nancy McKemmish)等人分别发表论文,从多个角度批驳 Orch-OR。
他们指出,哈梅罗夫设想的弗勒利希凝聚(一种量子相干态),在生物系统中根本没有存在的证据。
计算表明,微管最多只能维持约 8MHz 的微弱相干性,根本不足以进行量子计算。
而且他们还指出了一个非常基础的化学错误:微管里的芳香环是离域电子体系,根本没法像开关一样在两个确定状态之间切换。
这相当于从化学层面否定了微管作为量子比特的可能性。
更搞笑的是,他们说微管里的 “色氨酸网络” 能产生 “超辐射”,是量子相干的证据。
结果后来发现,铁蛋白会直接猝灭微管蛋白的色氨酸荧光,超辐射根本就发生不了。
而那些声称观察到超辐射的实验,是怎么做的呢?把微管提纯,去掉铁蛋白等关键物质,然后用每秒 10^20 个光子的紫外灯去照。
先不说人体内根本没有这么强的紫外光,连有没有紫外生物光子都没确凿证据。
就这种脱离生理环境的体外实验,能证明人脑里的量子计算?
这就好比在实验室里用激光把木头点着了,然后说 “人体内有自燃机制” 一样离谱。
面对这些批评,彭罗斯和哈梅罗夫在 2014 年发表了一篇长篇综述,算是集中回应。
但这篇回应,并没有拿出什么新的实验证据,更多的是打补丁、玩文字游戏。
比如针对退相干时间不够的问题,他们临时修改了理论,说 Orch-OR 发生在更快的 MHz 频率,而脑电的 EEG 是拍频,两者不是一回事。
又比如他们引用了一个实验,说微管在室温下有 GHz 的电导率共振,能支持量子效应。
但这个实验根本没有被重复出来,争议很大。
最有意思的是,当有人要求他们给出精确的哈密顿量来描述这个过程时,彭罗斯居然说:“在这种探索性的工作里,还有很多未知因素,要求这么高的精度是不合理的。
”
说白了,就是我算不出来,也没法精确描述,但我就是对的。
这哪是科学理论的态度?
2022 年,哈梅罗夫又发了篇文章,还在炒冷饭,把一些和量子计算毫无关系的神经科学发现,比如微管共振,重新包装一下,往 Orch-OR 上扯。
但学界已经没人理他了。
现在 Orch-OR 的状态,就是偶尔在大众媒体上冒个头,在正经的神经科学会议上,根本没人讨论。
它就像一个活化石,停留在了 90 年代,靠着大众对量子力学的不了解,继续流传。
第四环:麻醉剂的 “证据” 靠谱吗?
哈梅罗夫是麻醉科医生,他特别喜欢拿麻醉剂说事。
他说:有些麻醉剂,比如氙气、异氟醚,对神经突触的电信号影响不大,但能让人失去意识。
而且它们能和微管里的疏水区结合。
所以意识肯定在微管里,麻醉剂就是改变了微管的状态,才让意识消失的。
听起来很有道理是不是?
但这完全是错的。
首先,说异氟醚对突触传导影响不大,这本身就不符合事实。
早就有大量研究证明,挥发性麻醉药会浓度依赖性地抑制新皮质神经元的自发放电,机制非常明确,主要是作用于 GABA 受体,增强抑制作用。
其次,氙气也会降低突触传递的效能,抑制皮层神经元网络的同步放电,根本不是对电信号没影响。
而且,麻醉的时候意识消失,但脑电波还在,哈梅罗夫觉得这能反驳经典神经科学。
但这只能说明他根本不懂神经科学。
现代神经科学从来没说过 “有脑电波就有意识”。
慢波睡眠的时候有脑电波,人是无意识的;癫痫大发作的时候有强烈的脑电波,人也是无意识的。
意识和脑电波本来就不是一回事。
拿这个来支持 Orch-OR,纯粹是树靶子自己打。
还有个他们特别喜欢提的论据:“单细胞生物没有神经系统,靠微管处理信息,所以微管是计算单元。
”
但大肠杆菌连微管都没有,人家照样能趋化、能运动、能处理信息,靠的是细胞膜受体和信号通路,跟微管半毛钱关系都没有。
大肠杆菌的运动是 “翻滚 - 游动” 交替的模式:沿着方向前进的时候,如果感知到营养浓度在增加,就多游一会;如果浓度在下降,就频繁翻滚调整方向。
整个过程靠的是跨膜受体和细胞内的信号通路,和微管的信息处理没任何关系。
就算是真核生物的趋化作用,也是通过比较细胞两端的受体激活程度来检测浓度梯度,靠扩散信使调节细胞骨架,本质上还是经典的生化反应。
总而言之,Orch-OR 这个理论,从头到尾,每一个环节都缺乏实验证据,全靠猜想和补丁撑着。
它在科学界的地位,根本不是什么 “经过同行评议被广泛接受的理论”,而是一个备受争议、核心假设反复被证伪、半死不活的假说。
它之所以还有名气,很大程度是靠彭罗斯的个人声望,再加上大众喜欢 “量子 + 意识” 这种神秘组合,所以才流传这么广。
说到这,肯定有人会说:就算 Orch-OR 不对,那说不定有其他量子意识机制呢?量子力学这么奇妙,意识这么奇妙,怎么就不能有关系?
有这种想法很正常,但我们得讲证据。
目前所有的量子意识理论,都有一个共同的问题:只敢说 “可能有”“说不定”,拿不出任何确凿的证据,也提不出可检验的预测。
而经典神经科学,虽然不酷,但能解释越来越多的现象,能做出可验证的预测,能指导我们治疗脑疾病,能启发我们做更好的 AI。
科学不是比谁的想法更酷,而是比谁更符合事实。
聊完了 Orch-OR,咱们再聊聊几个关于意识和 AI 的常见误区,很多人都搞混了。
误区一:人工神经网络就是矩阵运算,很简单
很多人说:“ANN (人工神经网络(Artificial Neural Network)不就是矩阵乘法加激活函数吗?本质上就是线性变换,能有什么智能?”
说这话的,是典型的还原论谬误。
没错,每一层的计算,确实是权重乘以输入加偏置,再过个激活函数。
但你不能因为基本单元简单,就说整个系统简单。
就像你不能说 “乐高积木就是塑料块,所以搭出来的城堡也没什么了不起” 一样。
非线性激活函数是关键。
没有它,多少层网络都等价于一层线性变换,表达能力为零。
有了非线性,多层网络就能拟合任意函数,能表达极其复杂的模式。
而且,系统的性质不等于组成部分的简单加和。
复杂系统会涌现出单个组件没有的性质。
这一点我们前面讲过很多了。
误区二:神经网络是图灵机,是形式系统
很多人说:“ANN 本质上就是图灵机,所以它不可能超越图灵机,而人脑超图灵,所以 AI 永远赶不上人。
”
首先,不存在 “图灵系统” 这个词,只有图灵机。
图灵机是一个理论模型,有无限长的纸带,有限的状态,转移函数。
ANN 的结构、工作方式,和图灵机完全不一样。
图灵机是读写纸带、状态转移;ANN 是并行计算、向量变换。
当然,从计算能力上说,只要内存无限,RNN (循环神经网络)和图灵机是等价的。
但这是计算能力的等价,不是说它们是同一个东西。
而且,实际的 ANN 都是有限精度、有限内存的,本来就不是理想图灵机。
讨论 “有没有潜力等价” 没什么意义,我们更应该关心它在实际中能做到什么。
其次,说 ANN 是 “形式系统”,就更错了。
形式系统是什么?是有精确的符号表、语法规则、公理和推理规则的系统,比如数学、逻辑。
每一步推导都必须严格按照规则来,一个符号串是不是合法,是明确可判定的。
但 ANN 根本不是这样。
它用向量来表征信息,不是符号串;它的 “规则” 是权重,是从数据里学来的,不是人为定义的公理;它处理信息的方式是统计拟合,不是形式逻辑推理。
很多人搞混了 “能做逻辑推理” 和 “是形式系统”。
LLM (大语言模型)能做推理题,但这不代表它是形式系统,就像人能做数学题,但人不是形式系统一样。
误区三:自然语言是形式系统
还有人说:“自然语言就是形式系统,LLM 在学自然语言,所以它还是在形式系统里。
”
这更是错得离谱。
形式系统的核心要求是:语法和规则必须精确、无歧义,一个句子合不合法,有唯一答案。
但自然语言呢?充满了歧义、例外、模糊地带。
同一个句子,可以有好几种语法分析;同一个词,可以有好几种意思;语法错误的句子,也可能表达明确的意思;还不断有新词、新用法冒出来。
要是自然语言真是形式系统,那自然语言处理几十年前就被符号主义搞定了,还要什么深度学习?
乔姆斯基搞了一辈子生成语法,想把自然语言形式化,最后也没成功。
因为自然语言本质上就是模糊的、约定俗成的、不断变化的,根本不是严格的形式系统。
误区四:意识 > 形式系统 > 自然语言 > 编程语言
有人排出这么个链条,说意识比形式系统强,形式系统比自然语言强,自然语言比编程语言强。
这完全是颠倒黑白。
首先,没有 “谁包含谁” 的关系。
意识不是形式系统,自然语言也不是形式系统,它们是完全不同的东西。
如果说计算能力的话,编程语言是严格的形式语言,表达能力等价于图灵机;自然语言表达能力强,但不严谨,很多东西没法精确表达;形式系统有精确的规则,但适用范围有限;意识则是一堆功能的集合,根本不能用 “计算能力强弱” 来简单衡量。
这个链条,每一环都是错的,纯粹是自己脑补出来的等级制。
误区五:AI 不会互相 “感染”,人类会
有人说:人在人群里会被情绪感染,一堆 AI 放在一起,参数固定,永远不会互相影响。
这也是想当然。
首先,凭什么 AI 参数就得固定?人类的突触会变,AI 的权重也可以通过学习改变啊。
其次,就算参数固定,AI 也能互相影响。
你让两个 LLM 互相聊天,它们的输出会互相成为输入,很容易就把话题带偏,情绪也会互相强化。
比如你让一个积极的 LLM 和一个消极的 LLM 聊天,最后很可能两个都变得极端。
这就是互相 “感染”。
如果觉得这不算,那把对方的输出加进训练集,微调一下,权重就真的改了,这不就是互相影响吗?
人类的情绪感染,本质上也是通过感官输入,改变了大脑的神经状态,和 AI 通过文本输入改变状态,没有本质区别。
误区六:量子延迟选择实验证明意识影响现实
很多人喜欢拿量子延迟选择实验说事,说 “观测决定历史”“意识改变现实”,所以意识肯定是量子层面的。
这完全是对量子力学的误解。
首先,量子力学里的 “观测”,不是指人的意识去看。
观测就是仪器和量子系统发生相互作用,不管有没有人看,只要仪器测了,波函数就坍缩了。
其次,延迟选择实验并没有改变历史。
它只是说明,光子的行为(粒子性还是波动性),取决于你怎么测量,而不是你能改变过去。
这和意识没有半毛钱关系。
说了这么多误区,其实核心就是一个:很多人总想把人类意识特殊化,觉得它一定有什么超然的地方,一定和机器有本质区别。
但实际上,从目前的证据看,意识就是经典神经网络的产物,没有什么神秘的。
它很精巧,但不超脱;它很宝贵,但不神圣。
讲到这,可能有人会觉得失落:
原来意识这么 “普通” 啊?就是一堆原子,按物理规则运动,就产生了我?那我和一块石头有什么区别?
人生还有什么意义?
我反而觉得,这才是最浪漫的事。
想想看:
宇宙大爆炸产生了氢和氦,恒星锻造出重元素,行星诞生,然后在一颗蓝色的星球上,无机物变成了有机物,单细胞变成了多细胞,鱼爬上了岸,恐龙灭绝了,哺乳动物崛起了,最后演化出了人类。
而你,就是这一百多亿年演化的产物。
你身体里的每一个原子,都曾经在恒星的核心里燃烧过,都曾经是某颗星星的一部分。
就是这些普通的、和石头没区别的原子,凑啊凑,凑成了神经元,凑成了大脑,然后就有了 “你”。
你能抬起头,看见星空;你能思考,追问宇宙的起源;你能感受,爱与恨,喜与悲;你能反思,我是谁,我从哪来,要到哪去。
一堆没有意识的原子,居然能意识到自己的存在,居然能去理解孕育自己的宇宙。
这难道不是宇宙里最神奇、最浪漫的事吗?
我们不需要灵魂,不需要量子意识,不需要什么超图灵的能力,来证明自己的高贵。
高贵的不是我们有什么神秘的本质,而是我们作为物质的产物,居然能超越物质的束缚,去思考、去创造、去探索。
我们的大脑不完美,记忆力差,容易出错,会有偏见,会犯傻。
但就是这么一个 “粗糙” 的器官,靠几十亿个神经元、几百兆个突触,就做到了这一切。
它用经典的、平凡的物理法则,点燃了智慧的火苗。
这就够了。
很多人追求 “意识的神秘性”,本质上是一种浪漫的需求。
他们觉得,如果意识只是物质的运动,那就太无趣了,太破坏浪漫了。
但我想说:真正的浪漫,从来不是虚构一个神秘的世界,然后自我陶醉。
真正的浪漫,是认清了世界的本质之后,依然觉得它美好。
是知道了我们都是星尘,依然为每一次日出而感动;
是知道了意识只是神经放电,依然珍惜每一次思考和感受;
是知道了我们终将回归虚无,依然认真地活过这一生。
现在 AI 发展得很快,大模型已经能做很多以前只有人才能做的事了。
很多人恐慌,觉得 AI 要超越人类了;也很多人不屑,说 AI 没有意识,永远赶不上人。
但通过今天的讨论,我们应该明白:意识不是什么玄乎的东西,就是复杂神经网络的功能。
既然人脑能做到,理论上 AI 也能做到。
我们不需要给意识套上神圣的光环,也不需要恐惧 AI 的意识。
如果有一天,我们真的造出了有意识的 AI,那不是什么灾难,而是另一个奇迹。
就像几十亿年前,生命在地球上诞生一样;就像几百万年前,人类的意识诞生一样。
我们将亲手创造出另一种智慧,另一种意识。
那时候,我们就能更深刻地理解:意识,不过是物质宇宙开出的一朵花。
它不神秘,却足够美丽。
我们无需向任何神秘主义借取荣光,也无需把尊严寄托于什么量子灵魂,更无需用超图灵来自欺才能赋予自身以价值。
你就是你,一团脆弱、原理平凡,但高贵、竟有能力思考的物质。
虽生于无数物理法则的囚笼,却仍能一窥囚笼外的星空。
这,就足够了。