量子计算,为什么要争三微秒
量子竞赛开始争控制层
量子计算正在发生一个不太显眼的变化:竞争不再只围绕量子比特数量,也开始争夺量子机器背后的经典控制层。
冲突在于,量子处理器可以展示新纪录,却不能独立完成实时纠错、信号解码和任务调度。
每一次测量之后,经典计算系统都要在极短时间内判断、反馈,再把控制指令送回硬件。
这意味着,未来的量子计算机更像一座异构数据中心,而不是一只孤立的量子芯片。
量子比特决定理论上限,控制系统决定工程上限。
三微秒背后,是一条闭环
9月10日,光子量子计算公司Xanadu与AMD发布Backline。
它把CPU、GPU、FPGA和量子处理器放进同一套异构计算框架,让开发者通过PennyLane的Python接口描述任务,再由编译与传输层把工作分配到不同硬件。
Xanadu披露,Backline实现了低于3微秒的端到端量子—经典闭环延迟,并称标准AMD EPYC或Threadripper CPU也能承担部分低时延任务。
PennyLane 0.46.0 Beta 1的发布说明已经出现对应组件,可配置控制器、协处理器和传输层,并把量子纠错中的解码交给GPU或预编译程序。
但边界必须说清:三微秒是公司测试口径,尚不能代表所有量子硬件、网络环境和纠错任务;Beta功能也不等于成熟商用系统。
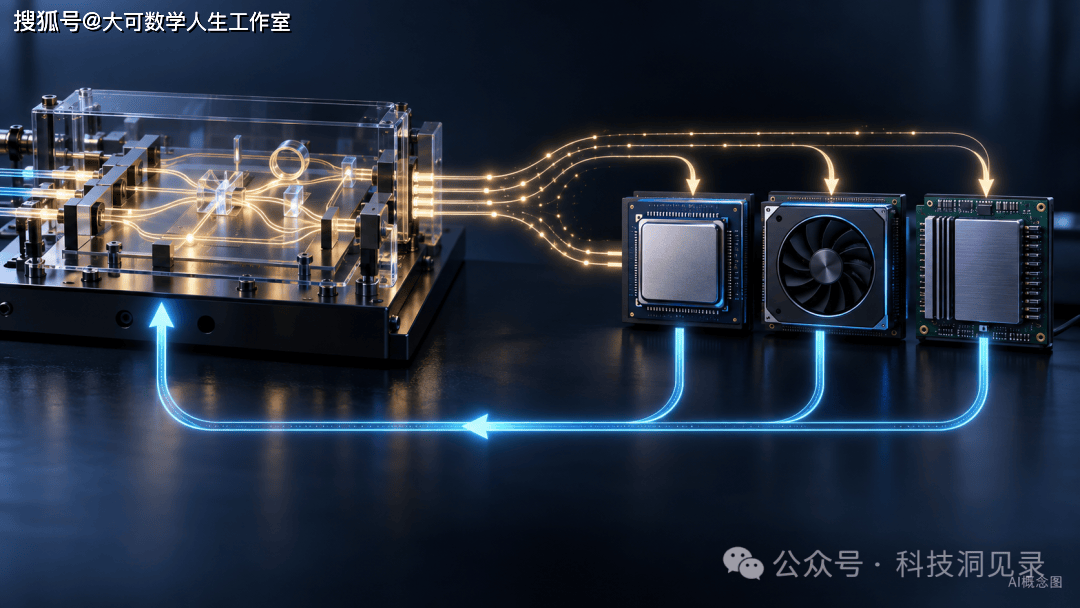
AI概念图:展示通用量子—经典控制关系,不代表真实设备、实测线路、性能认证或商业部署。
为什么经典计算反而更重要
量子纠错不是在计算结束后做一次复盘,而是要持续测量错误征兆、执行解码、决定修正,再把控制信号送回量子设备。
延迟过高或抖动过大,反馈就可能赶不上量子状态变化。
这也是CPU、GPU、FPGA和高速网络同时出现的原因:CPU擅长通用控制,GPU适合并行解码,FPGA更接近确定性低时延,网络负责把这些节点连成闭环。
真正困难的,不只是单个芯片快,而是整条链路可编程、可预测、可扩展。
量子计算真正缺的,不只是更好的量子芯片,而是能把多种硬件组织成一台机器的系统工程。
制造层也在同步补课
就在Backline发布前一天,Xanadu与ASML宣布探索光子量子芯片的先进光刻工艺。
双方关注的一个具体问题,是线边缘粗糙度可能造成光散射与损耗,进而影响容错和纠错所需的光子质量。
这项合作仍处探索阶段,没有披露工艺节点、损耗改善、设备投入或量产时间表。
但它与Backline放在一起,释放出同一个信号:量子计算正在同时补两层基础设施——向下补制造一致性,向上补实时控制和软件接口。
加拿大政府此前还宣布,将为Xanadu总额8.93亿加元的先进量子制造项目投入1.95亿加元,面向光子与半导体器件的集成、封装、测试和组装。
这里的金额是项目与政府投入安排,不是Backline收入,也不代表设施已经建成。
AI概念图:展示通用产业栈,不代表特定公司设备、投资完成、客户订单或量产状态。
新增价值会流向哪些环节
如果量子计算逐步走向可用系统,新增价值不会只落在量子处理器。
光刻、光子封装、激光器、探测器、低温或光学系统、测控电子、高速网络、CPU/GPU/FPGA、编译器和开发平台都会进入同一条交付链。
谁掌握未来入口?很可能是能把不同量子硬件和经典计算连接起来的软件接口与编译层。
谁更接近定价权?则要看谁能把延迟、抖动、纠错吞吐、光损耗、制造良率和持续运行做成可验证指标。
基础设施的价值,往往出现在最难替换、又最容易被忽略的接口层。
未来三到五年,看系统指标
未来3—5年,量子行业仍会讨论量子比特,但企业和科研机构会越来越关注端到端指标:反馈延迟是否稳定,纠错吞吐能否扩展,制造损耗能否下降,不同硬件是否兼容,系统能否连续运行,以及开发工具能否降低实验成本。
对企业管理者,最值得建立的不是“量子很快改写所有行业”的预期,而是对应用门槛、集成成本和验证周期的判断。
对工程人才,异构计算、实时系统、编译器、光子制造、封装测试和量子纠错之间的交叉能力,会更稀缺。
保持长期主义,就是把每一次微秒级进展放回完整系统里看。
真正的量子产业化,不会由一个数字宣布完成,而会被一条条稳定闭环慢慢证明。